Memória de agentes de IA: o que é e por que muda o atendimento
Memória de agentes de IA é o que faz um agente lembrar do histórico de cada cliente entre conversas. Veja os tipos de memória e como testar se o seu tem de verdade.
Neste artigo
- O que é memória de agentes de IA
- Os três tipos de memória que um agente usa
- O que acontece quando falta memória de longo prazo
- Memória não é a mesma coisa que base de conhecimento
- Como a memória de longo prazo funciona por trás
- Memória entre canais: WhatsApp, site e Telegram como se fosse uma só conversa
- Como saber se o seu agente tem memória de verdade
Um cliente manda mensagem pro WhatsApp da empresa. Fala o nome, o problema, o que já tentou. Dois dias depois, escreve de novo com uma dúvida relacionada. O agente de IA responde como se fosse a primeira conversa da vida dele: pede o nome de novo, pergunta o problema de novo, ignora tudo que já foi dito. Isso não é falta de inteligência do modelo. É falta de memória.
O que é memória de agentes de IA
Memória de agentes de IA é a capacidade de um agente guardar e usar informação de conversas passadas para responder melhor no futuro. Sem memória, cada interação começa do zero, mesmo que seja o décimo contato do mesmo cliente.
Isso é diferente de “o modelo é inteligente”. Um modelo de linguagem, sozinho, não lembra de nada entre uma conversa e outra: ele só enxerga o que está na janela de contexto daquela sessão específica. Memória é a camada que existe por cima do modelo, feita pra guardar o que importa e trazer de volta na hora certa.
Os três tipos de memória que um agente usa
Na prática, “memória de IA” não é uma coisa só. São três camadas diferentes, cada uma resolvendo um problema diferente.
| Tipo | O que guarda | Duração |
|---|---|---|
| Memória de curto prazo | O que foi dito nesta conversa, agora | Só a sessão atual |
| Memória de longo prazo | Fatos sobre a pessoa: preferências, histórico, decisões já tomadas | Persiste entre conversas |
| Memória semântica | Conhecimento geral da empresa: políticas, produto, FAQ | Fixa até alguém atualizar |
A memória de curto prazo é o que todo modelo já tem de graça: a janela de contexto da conversa atual. A de longo prazo é o que falta na maioria dos chatbots simples: lembrar que aquele cliente já resolveu um problema parecido mês passado, ou que prefere respostas curtas. A semântica é o que normalmente chamamos de base de conhecimento: não muda de pessoa pra pessoa, é a mesma pra todo mundo.
Um agente bom usa as três ao mesmo tempo. Um agente que só tem a primeira parece burro depois da segunda mensagem.
O que acontece quando falta memória de longo prazo
O sintoma mais comum é o cliente falando “já falei isso” ou “de novo?”. Mas o problema vai além do incômodo.
- Vendas perde contexto de lead. Um SDR de IA que não lembra que o lead já disse o orçamento disponível volta a perguntar, e o lead desiste de responder pela terceira vez.
- Suporte repete diagnóstico. Um cliente que já passou por três etapas de troubleshooting numa conversa anterior tem que refazer tudo do zero na próxima.
- Onboarding trava. Um funcionário que já perguntou “como peço reembolso” semana passada ouve a mesma explicação genérica de novo, em vez de uma resposta que já leva o contexto dele em conta.
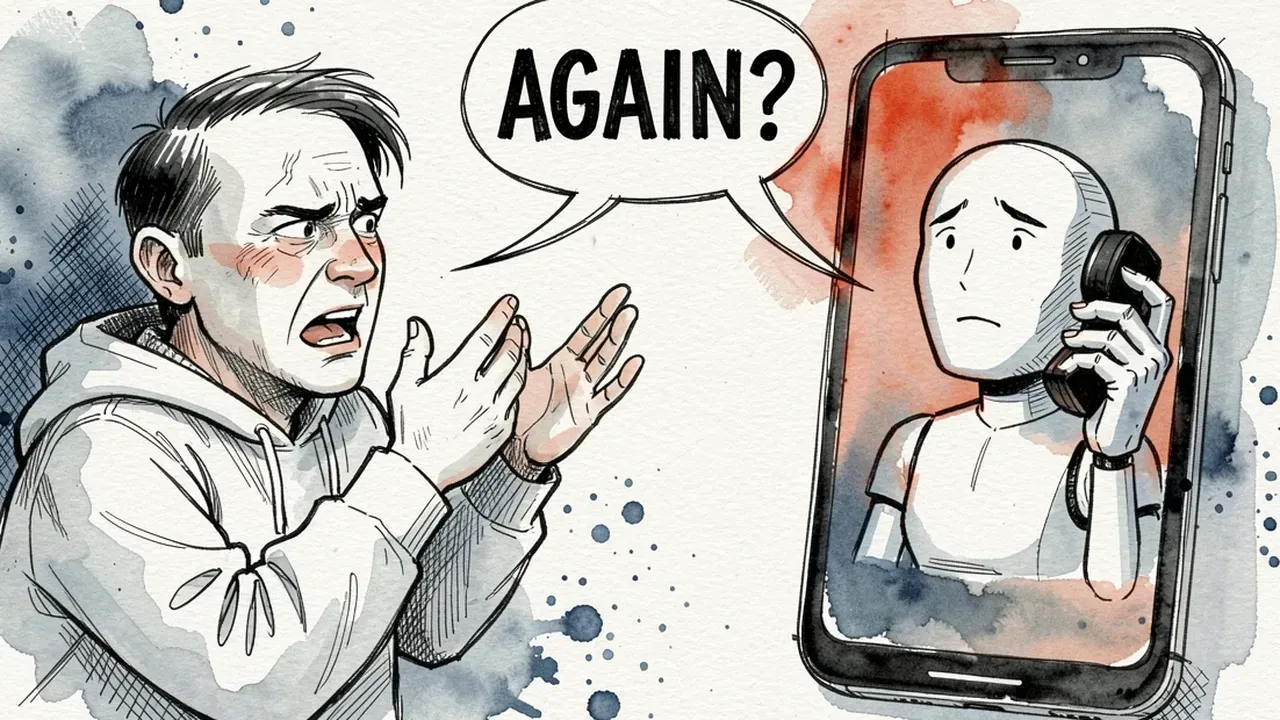
Em todos os casos, o custo não é só a irritação. É tempo. Cada vez que o agente esquece, alguém, humano ou não, paga o preço de reexplicar.
Memória não é a mesma coisa que base de conhecimento
Essa confusão é comum e vale desfazer. Base de conhecimento é estática: PDFs, políticas, FAQ, o mesmo texto pra qualquer pessoa que perguntar. Memória é dinâmica e pessoal: o que aquele cliente específico já disse, decidiu ou precisou antes.
Um agente pode ter uma base de conhecimento excelente e ainda assim parecer amnésico, se não guarda nada sobre a conversa individual. E o contrário também é verdade: memória sem base de conhecimento sólida vira um agente que lembra do cliente, mas erra o produto.
Como a memória de longo prazo funciona por trás
Não precisa entender a engenharia pra usar bem, mas ajuda saber o princípio. A maioria das plataformas guarda cada fato relevante como um registro pequeno e separado, não a conversa inteira, associado à pessoa. Quando uma nova mensagem chega, o sistema busca só os fatos relevantes pra aquele contexto e injeta isso na resposta.
Isso é diferente de simplesmente “colar a conversa inteira de novo” no modelo. Conversa inteira custa caro em tokens e piora a qualidade da resposta: quanto mais contexto irrelevante, mais o modelo se perde. Memória bem feita é seletiva. Traz o fato certo, na hora certa, sem lotar a janela de contexto com coisa que não importa pra pergunta de agora.
Memória entre canais: WhatsApp, site e Telegram como se fosse uma só conversa
Cliente começa a conversa no WhatsApp, some, volta pelo site duas semanas depois. Do ponto de vista dele, é a mesma conversa, só mudou de tela. Do ponto de vista de um sistema sem memória compartilhada, são duas pessoas diferentes.
Isso é um problema maior do que parece. Empresas que atendem por mais de um canal, a maioria, perdem contexto toda vez que o cliente troca de canal, mesmo se cada canal individual tiver memória própria. O agente do WhatsApp lembra da conversa do WhatsApp. O agente do site não sabe que ela existiu.
A solução não é técnica, é de arquitetura: a memória precisa estar amarrada à pessoa, não ao canal. Um agente bem construído reconhece o mesmo cliente em WhatsApp, Telegram ou site e traz o histórico completo, independente de onde a conversa recomeçou.
Como saber se o seu agente tem memória de verdade
Um teste rápido, sem precisar olhar código:
- Fale com o agente e dê uma informação pessoal (nome, preferência, um problema específico).
- Espere um dia. Volte com uma pergunta relacionada, sem repetir o contexto.
- Veja se o agente usa a informação de antes ou pergunta tudo de novo.
- Repita com um fato que devia mudar o tom da resposta, como “prefiro respostas curtas”.
Se o agente passa no teste, ele tem memória de longo prazo de verdade. Se pede tudo de novo, o que você tem é um modelo de linguagem bem escrito, não um agente que conhece o seu cliente.
Memória de longo prazo é o que separa um chatbot genérico de um agente que efetivamente lembra de quem está do outro lado. O SquadOS roda com dezenas de modelos e processamento multimodal nativo, com até 95% de economia em tokens, sem você precisar montar essa engenharia de memória do zero.